

Wyobraźmy sobie taką sytuację: poszukując pracy na stanowisku redaktora(-rki) miesięcznika „Znak”, oprócz CV i listu motywacyjnego rekruter prosi także o udostępnienie naszych profili w mediach społecznościowych. Celem jest sprawdzenie, czy nasza osobowość pasuje do kultury pracy w redakcji. Przechodząc do drugiego etapu, odbywamy zdalną rozmowę kwalifikacyjną, która analizowana jest m.in. przez sztuczną inteligencję pod kątem naszych reakcji i wyników testów psychologicznych. A te niepostrzeżenie rozwiązujemy podczas zadań rekrutacyjnych pod pozorem grania w gry komputerowe.
To nie opis jednego z odcinków serialu Black Mirror czy technologicznej fikcji, powstałej w głowach któregoś z autorów science fiction. To już powszechna praktyka stosowana przez duże korporacje przy zatrudnianiu kandydatów w Stanach Zjednoczonych. Wspomaganie działów osobowych wyspecjalizowanymi algorytmami i danymi dotyczącymi naszego stylu życia ma zapewnić szybkość procesu, bezstronność i równe szanse w zatrudnieniu. Czy aby na pewno?
Broń matematycznej zagłady
Problemy z „obiektywnymi” algorytmami rekrutacyjnymi opisuje m.in. Cathy O’Neil w głośnej książce Broń matematycznej zagłady. O’Neil – matematyczka, która przez lata pracowała w branży zajmującej się modelowaniem dużych zasobów danych – podaje w niej niezliczone przykłady wykorzystania algorytmów, które okazały się dalekie od przypisywanej im neutralności. Od usług publicznych przez zatrudnienie, ewaluację pracowników, rekrutację na studia, bankowość po aplikacje randkowe: algorytmy sztucznej inteligencji wykorzystywane są w coraz większej liczbie dziedzin naszego życia. Według Raportu ONZ z 2019 r. nowe technologie stosowane w polityce społecznej dotykają rosnącej liczby obywateli, tworząc nową koncepcję rządzenia nazywaną „cyfrowym welfare state”.
Czy tego chcemy, czy nie, pozostawiamy po sobie mnóstwo śladów, danych i informacji, które są następnie zestawiane, przetwarzane i modelowane w systemy rozpoznawania i kalkulowania ryzyka, nie pozostając bez wpływu na naszą codzienność. O’Neil, a z nią wiele innych badaczek udowadniały, że dynamicznie rozwijająca się branża AI (Artificial Intelligence), dostarczając przełomowych rozwiązań, nie tylko czyni nasze życie wygodniejszym i łatwiejszym, ale może mieć na nie także negatywny wpływ. Bez Big Data nie bylibyśmy w stanie zrozumieć planetarnej skali zmian klimatycznych, „zobaczyć”, jak wygląda czarna dziura, ani znaleźć czegokolwiek w przepastnej sieci internetu. Ale prospołecznie nastawieni naukowcy, aktywistki, prawniczki oraz technologiczni „sygnaliści” dostarczają coraz nowszych przykładów wykorzystania algorytmów w różnych systemach, które mają skutki dyskryminujące lub wprost posługują się uprzedzeniami. Nieprzejrzyste, wykorzystywane na masową skalę i niekiedy krzywdzące systemy O’Neil nazywa właśnie bronią matematycznej zagłady. Matematyka i statystyka mają bowiem znacznie większy wpływ na stan naszego konta, zdolność kredytową, awans lub zwolnienie z pracy, a w ekstremalnych przypadkach także na naszą wolność, niż nam się powszechnie wydaje.
W swojej książce autorka opisuje np. badania amerykańskich naukowców, którzy sfabrykowali kilka tysięcy podań o pracę, a następnie wysyłali je w odpowiedzi na ogłoszenia rekrutacyjne. Analogiczne pod kątem kwalifikacji życiorysy różniły się jedynie danymi kandydatów: połowa z nich prezentowała osoby białe, pozostałe zaś były podpisywane nazwiskami sugerującymi pochodzenie afroamerykańskie. Badacze stwierdzili, że „białe” nazwiska wzbudzały zainteresowanie o połowę częściej niż „czarne”. W 2018 r. z kolei dziennikarze odkryli, że algorytmy firmy Amazon odrzucały podania na stanowiska techniczne i inżynierskie pochodzące od kobiet. W tym przypadku powodem była konstrukcja modelu, który oparty na idealnym kandydacie z przeszłości – mężczyźnie, bo oni dominują w branży IT – szukał po prostu podobnych typów. Ostatecznie algorytm został wycofany. Czasami jednak wiara w algorytmy może doprowadzać do znacznie większych nierówności w traktowaniu.
Raport mniejszości
W 2016 r. niezależna organizacja pozarządowa ProPublica opublikowała niepokojący raport dotyczący algorytmu COMPASS używanego w kilku amerykańskich stanach, który ocenia prawdopodobieństwo popełnienia kolejnych czynów karalnych przez aresztowanych. Okazało się, że wykazywał on uprzedzenia wobec osób czarnoskórych, u których ryzyko recydywy oceniał znacznie wyżej niż u innych, mimo oczywistych przesłanek, które powinny wskazywać coś odwrotnego. Jeśli osoba zatrzymana została wcześniej skazana jedynie za wykroczenia, ale była czarnoskóra, jej stopień ryzyka oceniano jako znacznie wyższy niż u osoby o białym kolorze skóry skazanej uprzednio za poważne przestępstwa, takie jak napad czy przemoc domowa. Ryzyko popełnienia przyszłych czynów karalnych było kalkulowane na podstawie przeszłości aresztowanego, a także informacji na temat jego zamieszkania i sytuacji rodzinnej. Jak udowadniali twórcy raportu, algorytm był nie tylko rasistowski, ale i wysoce nieskuteczny: jedynie 20% osób z wysokim prawdopodobieństwem popełnienia groźnych przestępstw faktycznie się ich dopuszczało.
###banner###
Jeśli COMPASS przypomina fabułę Raportu mniejszości, to podobnie ambitne założenia mają modele uczenia maszynowego do prognozowania miejsc przyszłych przestępstw. Jeden z takich systemów (choć nigdy niewdrożony) w ramach międzynarodowego konkursu projektowała polska firma deepsense.ai. Na czym polegał model opracowany przez Polaków? Ich predykcja kryminologiczna dzieliła daną dzielnicę na mniejsze obszary i zliczała przestępstwa, które w nich popełniono w przeszłości. Założeniem było tutaj, że im więcej czynów kryminalnych występowało w danym obszarze, tym bardziej wzrasta prawdopodobieństwo popełnienia kolejnych. W tym algorytmie wykorzystywane są tylko dane historyczne (milion przestępstw zebranych w ciągu pięciu lat), w innych także dodatkowe czynniki, takie jak demografia, pogoda, a nawet informacje zbierane z mediów społecznościowych.
W przypadku zidentyfikowania miejsc o największym współczynniku kryminogenności policja może wysłać do nich dodatkowe patrole. Jednak w wielu niedofinansowanych dzielnicach, gdzie obywatele wchodzili w konflikty z policją lub wcześniej byli przez nią niesprawiedliwie traktowani, pojawienie się funkcjonariuszy ma efekt drażniący i może wywoływać agresję. Mowa np. o dzielnicach zamieszkanych przez społeczności, gdzie akty przemocy wybuchały często właśnie z powodu konfliktów z białą policją, a w polskich warunkach o blokowiskach, gdzie niechęć do służb porządkowych często przekazywana jest z pokolenia na pokolenie. Możemy też zapytać, co z pozostałymi przestępstwami, takimi jak gwałty, morderstwa czy przemoc domowa, które zazwyczaj popełniane są nie na ulicach, lecz w domowym zaciszu.
Jeszcze innym celem nowych technologii policyjnych takich jak Operation LASER jest identyfikowanie konkretnych osób, które z większym prawdopodobieństwem będą zaangażowane w działalność przestępczą. Oprogramowanie do nadzoru mediów społecznościowych wydobywa i analizuje informacje osobiste i powiązane dane z platform. Dane te są wykorzystywane do przewidywania wzorców zachowań oraz połączeń między użytkownikami i innymi ludźmi.
Według Citizen Lab, kanadyjskiej organizacji znanej w Polsce z raportowania stosowania oprogramowania śledzącego Pegasus, używanie systemów wykorzystujących wszystkie lub niektóre z wymienionych technologii poważnie narusza prawa człowieka. Badacze wskazują m.in. na naruszenia prawa do prywatności, prawa do pokojowych zgromadzeń i zachowania na nich anonimowości, a także prawa do równości, naruszanego poprzez automatycznie implementowane uprzedzenia, ukierunkowywanie modeli na określone grupy społeczne czy wreszcie brak transparentności – i w związku z tym trudności w odwołaniu się, jeśli nieznane są dokładne kryteria podejmowanych decyzji. „O ile technologie policyjne wykorzystujące algorytmy mogą wydawać się przyszłościowe, to nie da się ich oddzielić od przeszłości. Są one oparte na danych historycznych, które wpisują się w systemową dyskryminację i kolonializm w kanadyjskim systemie karnym” – piszą autorzy raportu Citizen Lab. Ponad 80 naukowców i naukowczyń pracujących w dziedzinie sztucznej inteligencji apelowało do wielkich platform, by zaprzestały sprzedaży swojego oprogramowania policji. W 2020 r. Amazon, IBM i Microsoft ogłosiły ograniczenia w sprzedaży swoich algorytmów do czasu wyjaśnienia nieścisłości.
W 2019 r. amerykański National Institute of Standards and Technology poddał audytowi kilkadziesiąt systemów rozpoznawania twarzy używanych w setkach aplikacji. Z ich analizy wynika, że większość z nich znacznie różniła się od siebie pod kątem skuteczności prawidłowego rozpoznawania tożsamości lub, co gorsza, wskazywała fałszywie dodatnie wyniki, które mogły prowadzić do utożsamienia osoby zupełnie niewinnej z poszukiwanym przestępcą. Wszystkie błędy w dokładności ujawniły się na grupach osób niebiałych, szczególnie zaś Afroamerykanów. To tylko kilka jaskrawych przykładów algorytmicznych uprzedzeń, które coraz częściej wypływają na światło dzienne, każąc nam zadawać pytania o etykę stosowania zautomatyzowanych modeli podejmowania decyzji.
Skąd się biorą kłopoty?
Czy algorytmicznych uprzedzeń można uniknąć? Uprzedzenia to psychologiczne, naturalne w gruncie rzeczy heurystyki, które stosujemy w codziennym życiu, aby ułatwić sobie podejmowanie decyzji, uprościć wybory i dokonywać szybkich ocen. Nikt nie jest od nich wolny, wszyscy do pewnego stopnia nieświadomie je stosujemy. Powtarzamy je jednak, budując modele sztucznej inteligencji i algorytmy używane później na szeroką skalę, co sprawia, że stają się tym niebezpieczniejsze. Źródła uprzedzeń w modelach matematycznych są trojakie.
Pierwszym i bodaj najważniejszym problemem mogą być po prostu kiepskie dane używane do trenowania algorytmów. Jak pisze w swojej książce „Raw Data” is an Oxymoron („Surowe dane” to oksymoron) Lisa Gitelman, nie istnieją obiektywne, nieprzetworzone czy tytułowe „surowe” dane. Każdy zestaw danych jest zbierany za pomocą wybranej metodologii i próbki, które dobierane są subiektywnie przez badaczy i analityków. Dane zbierane wybiórczo, przy użyciu starych metod (np. sondaży wyborczych ciągle w wielkim stopniu robionych przez stacjonarne telefony), luki w danych czy bardzo małe próbki potrafią zafałszować wszystkie kolejne kroki w procesie budowania modeli. Udowadniała to m.in. Timnit Gebru w swoich badaniach, krytykując użycie wielkich baz danych do rozumienia języka naturalnego stosowanych m.in. do stworzenia modeli językowej sztucznej inteligencji. Pokazywała bowiem, że modele służące do generowania języka takiego jak GPT-2 i 3 trenowane były na gigantycznych ilościach niefiltrowanych danych ściąganych maszynowo z internetu, m.in. z forum Reddit (którego użytkownicy swobodnie zamieszczają linki do interesujących ich portali) czy Wikipedii. W czym tkwi niebezpieczeństwo? 67% użytkowników Reddita w Stanach Zjednoczonych to mężczyźni pomiędzy 18. a 29. rokiem życia. A jedynie od 9% do 15% wikipedystów stanowią kobiety. W samym języku zakodowanych było więc wiele stereotypów, mizoginii, mowy nienawiści, rasizmu, idei ekstremistycznych oraz nacjonalistycznych. Czy naprawdę chcemy, by internetowy śmietnik, którym często bywa Reddit, posłużył za właściwy model ludzkiej komunikacji?
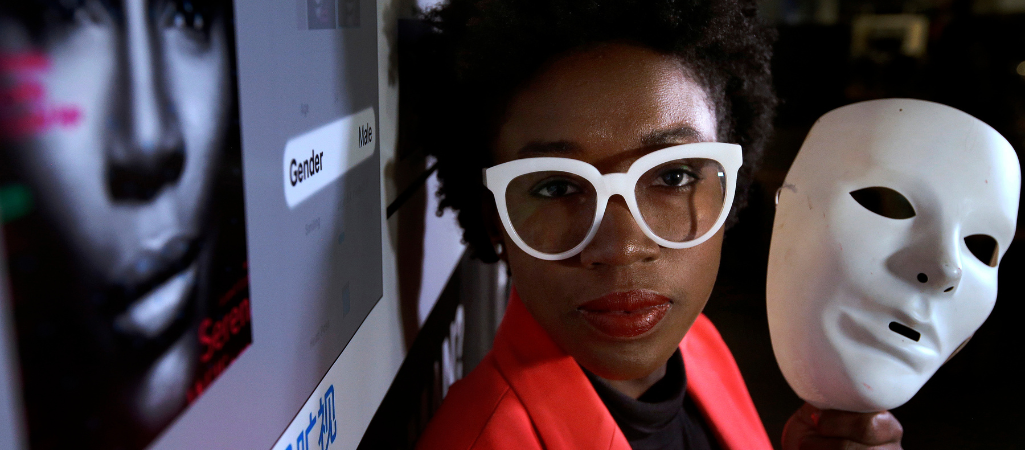
Skoro do modeli AI wkładamy dane historyczne, które często zawierają tradycyjne uprzedzenia i stereotypy, to poleganie na nich będzie powtarzaniem tych samych błędów w myśleniu. Wspomniana Timnit Gebru wraz z Joy Buolamwini w 2017 r. przedstawiła pracę Gender Shades (Odcienie płci). W swoich badaniach autorki pokazały, że algorytmy wykrywania twarzy największych gigantów technologicznych: Google, Amazona, IBM czy Microsoftu, szczycące się efektywnością na poziomie ponad 90%, o wiele gorzej radzą sobie z rozpoznawaniem twarzy o niebiałym kolorze skóry. Jak czytamy w artykule, w przypadku kobiet o ciemniejszej karnacji pomyłki modelu wynosiły aż 35% w porównaniu do 1% w przypadku kobiet białych. Co więcej, systemy AI wiodących firm nie zdołały poprawnie rozpoznać twarzy tak słynnych kobiet jak Oprah Winfrey, Michelle Obama i Serena Williams, klasyfikując je jako… męskie. Szerokim echem odbiła się także sprawa wyszukiwarki obrazów Google, która po wpisaniu w nią słowa „goryle” pokazywała zdjęcia czarnoskórych kobiet.
Drugi istotny problem stanowi mechanizm selekcji informacji. Skrzywienie jest możliwe przy próbie skwantyfikowania wartości powszechnie uważanych za pożądane. Przykładowo: kłopoty pojawiają się przy mierzeniu tak luźno zdefiniowanych pojęć jak sukces, uczciwość czy efektywność. Jak uczelnie obliczają wskaźnik sukcesu studenta, a tym samym swoją wartość i jakość klasyfikowaną na różnego rodzaju międzynarodowych listach rankingowych? Czy będą to oceny z egzaminów, znalezienie wymarzonej pracy, a może wysokość zarobków? Czy jeśli świeżo upieczony absolwent zdecyduje się na pracę wolontariusza w organizacji pomocowej, gdzie będzie zarabiał niewiele, lub trafi na rynek pracy w czasie kryzysu, znaczy to, że odniósł mniejszy sukces niż jego rówieśnik, który natychmiast po uzyskaniu dyplomu ląduje w dużej korporacji? Algorytmy nie są obiektywne, ale raczej ucieleśniają pogląd oparty na wartościach, że niektóre wyniki są lepsze lub ważniejsze od innych. Wybór konkretnej metryki wydajności przez twórcę algorytmu jest więc kluczowy dla określenia tych zaimplementowanych wartości.
Budowane obecnie modele językowe oparte na AI, takie jak GPT-3, mogą zwiastować tutaj dodatkowe problemy związane z wytworzeniem nowego sposobu wyszukiwania, który zastąpi dotychczasowy. Mówimy o radykalnym przeprojektowaniu tego, jak działałby Google, bo zamiast listy stron www, które odpowiadają na zapytanie, nasza interakcja z wyszukiwarką przypominałaby raczej dialog, w którym dostajemy konkretną odpowiedź na pytanie zadane w języku naturalnym. Marzeniem inżynierów z Google jest tu wyszukiwarka na kształt ludzkiego eksperta, który zamiast listy źródeł dawałby nam jasną odpowiedź. Możemy jednak zapytać: czy naprawdę ufamy temu ekspertowi? Jak moglibyśmy sprawdzić jakość takich odpowiedzi i mieć pewność, że nie bazują na dezinformacji, fake newsach czy propagandzie?
Trzeci problem wiąże się z tym, że źródłem uprzedzeń może być brak informacji zwrotnej na temat poprawności działania modelu. Bo czy kiedykolwiek uda nam się udowodnić, że gdyby jednak nas zatrudniono, to bylibyśmy świetnym i lojalnym pracownikiem, a gdyby przyznano nam kredyt, to bylibyśmy go w stanie spłacić? Model nie wie, czy nietrafnie określił jakąś osobę. A jak tłumaczy O’Neil: „Informacja zwrotna o błędach – w tym przypadku o osobach niesłusznie ocenionych negatywnie – jest badaczom niezbędna do przeprowadzenia analizy i ustalenia przyczyny błędu. Co zostało źle odczytane? Jakie dane niesłusznie zignorowano? Tak właśnie systemy uczą się i stają się mądrzejsze”.
Odpowiedzią – dobra regulacja
Skąd biorą się te pomyłki systemu? Wskazuje się na problem z brakiem różnorodności w sektorze IT, gdzie na stanowiskach inżynierskich dominują głównie biali mężczyźni. Taka homogeniczność skutkuje projektowaniem rozwiązań, produktów czy usług, które nie są dopasowane do perspektywy i doświadczeń innych grup: kobiet, mniejszości rasowych i osób z niepełnosprawnościami. Często narażają je na dyskomfort, czasami zaś na utratę zdrowia, a nawet życia, o czym pisała Caroline Criado-Perez w książce Niewidzialne kobiety. Nie inaczej jest z danymi. Budując systemy oparte na gigantycznych, lecz jednowymiarowych lub śmieciowych bazach danych, nie możemy liczyć na różnorodne i jakościowe wyniki. Badacze i badaczki zajmujący się problemem cyfrowych uprzedzeń twierdzą, że negatywne strony zautomatyzowanych systemów z reguły dotykają biednych, mniejszości i osoby z grup defaworyzowanych. Obserwują rosnące nierówności w tym obszarze, ponieważ usługi przeznaczone dla osób zamożnych częściej są zindywidualizowane i dostarczane przez ludzi czy też opiekunów klientów, natomiast biednych zwykle obsługują zautomatyzowane systemy.
Naukowcy i aktywiści twierdzą, że odpowiedzią na te formy dyskryminacji powinna być regulacja rynków cyfrowych. W Stanach Zjednoczonych, skąd pochodziły przytoczone przykłady cyfrowych uprzedzeń (w rekrutacji, rozpoznawaniu twarzy i profilowaniu policyjnym), polityka dotycząca komercyjnego zastosowania wrażliwych danych jest liberalna. Nieco inaczej sprawa wygląda w Unii Europejskiej, gdzie chroni nas RODO. Dzięki temu rozporządzeniu aby nasze dane poddane zostały analizie i przetwarzaniu, musimy np. wyrazić na to zgodę, co robimy kilkanaście razy dziennie, niestety, zwykle dość bezwiednie, klikając „Akceptuj wszystko” na kolejnych stronach internetowych. Joanna Mazur, analityczka DELab UW, którą zapytałam o prawne aspekty wykorzystania sztucznej inteligencji, mówi, że mimo iż regulacje europejskie nie pozwalają na tak daleko idące ingerencje jak te opisywane przez amerykańskich badaczy, to kwestia udzielanej zgody wciąż pozostaje problematyczna. Bo czy możemy tak naprawdę wyrazić świadomą konsekwencji zgodę na przetwarzanie naszych danych, zwłaszcza kiedy często jest ona nienegocjowalnym warunkiem korzystania z wielu serwisów i usług?
W Polsce także mieliśmy do czynienia z próbami stosowania systemów automatycznego podejmowania decyzji. W latach w 2014–2019 w urzędach pracy stosowano algorytm do profilowania bezrobotnych. Na podstawie wypełnionego kwestionariusza sugerował on urzędnikowi przypisanie osoby bezrobotnej do jednej z trzech kategorii, określających potencjał zatrudnieniowy oraz skalę przyznawanej pomocy. Profilowanie miało zagwarantować, że kryteria oceny będą jednolite, a podział środków do aktywizacji na rynku pracy oparty na „racjonalnych przesłankach i mierzalnych wartościach”. Sprawę ujawniła Fundacja Panoptykon, która wygrała proces z Ministerstwem Rodziny Pracy i Polityki Społecznej o ujawnienie algorytmu. Dzięki temu udało się „otworzyć” algorytm, odsłaniając jego założenia. Socjologowie od lat podejmujący temat tego, jak technologia może niepostrzeżenie zmienić proces podejmowania decyzji w obszarze polityk społecznych, badając jego założenia, odkryli, że algorytm profilowania nie spełniał nawet najbardziej podstawowych standardów metodologicznych, zarówno jeśli chodzi o rzetelność danych, jak i o dokonywane nań operacje statystyczne. Jak czytamy w artykule podsumowującym te badania: „Wymyślono, że wszystkich bezrobotnych cechuje pewna ukryta właściwość, której nadawano różne nazwy: potencjał aktywności zawodowej, aktywizacyjny czy zatrudnieniowy. Nie zdefiniowano jednak poprawnie, czym ta właściwość jest, i nie upewniono się, czy pomiar jest trafny. W praktyce oznacza to, że nie wiadomo, co mierzył algorytm profilowania używany we wszystkich urzędach pracy”. Praktyka ta wywołała oburzenie i system został wycofany po wyroku Trybunału Konstytucyjnego.
Ale już próby podejmowane przez Fundację Moje Państwo, aby wyjaśnić, w jaki sposób Ministerstwo Sprawiedliwości wykorzystuje algorytmy do przypisania spraw sędziom w sądach powszechnych, spełzły na niczym. Mimo informacji od samych sędziów skarżących się na niesprawiedliwe obłożenie pracą nie wiadomo, jakie kryteria bierze pod uwagę matematyczny model, przydzielając im sprawy. Także Centralne Biuro Antykorupcyjne odmówiło fundacji dostępu do informacji na temat algorytmu, który sprawdzał prawidłowość wydatkowania pieniędzy otrzymanych przez przedsiębiorców w ramach COVID-owej tarczy antykryzysowej. W wyżej wymienionych przypadkach nie wiemy, czy w grę wchodzą jakieś przejawy uprzedzenia, czy może dochodzić do nadużyć władzy, czy systemy są po prostu wadliwe.
Te przykłady wydają się dalekie od codziennych realiów, jednak na co dzień banki dokonują oceny naszej zdolności kredytowej nie tylko na podstawie oczywistych wskaźników, takich jak historia finansowa, spłacalność kredytów i zarobki, ale również wielu innych czynników demograficznych, behawioralnych i rodzinnych, które nie są przejrzyste dla wnioskującego. Będąc samotną matką na umowie-zleceniu, zamieszkującą robotniczą dzielnicę, z kilkoma nawet niewielkimi potknięciami finansowymi w życiorysie, nie dostanę kredytu w banku na zakup mieszkania, rozkręcenie własnego biznesu czy studia podyplomowe. Jeśli w internecie szukałam sposobów na oszczędzanie, to chętnie swoje produkty podsuną mi za to drapieżni dostawcy chwilówek z roczną stopą oprocentowania niejednokrotnie na poziomie kilkuset procent. Od niedawna w Polsce wprowadzono prawo do wyjaśnienia decyzji dla każdej osoby ubiegającej się o kredyt.
Autorzy wspomnianego na początku raportu ONZ przestrzegają przed ślepym podążaniem za możliwościami technicznymi, które implementowane bezrefleksyjnie, mogą nas zaprowadzić ku cyfrowej dystopii zamiast ku cyfrowemu państwu dobrobytu. Monitorowaniem działalności wielkich gigantów technologicznych zajmują się oddolne organizacje pozarządowe. Kiedy po publikacji swoich badań Gebru straciła pracę w zespole ds. etyki Google, założyła The Distributed AI Research Institute – grupę niezależnych badaczy sztucznej inteligencji, którzy nie są związani z żadnymi firmami z sektora Big Tech. Joy Boulamwini jest liderką Algorithmic Justice League, która poprzez raportowanie i działania artystyczne stara się działać na rzecz równości cyfrowej. Powstają kolejne społeczności (Black in AI, Queer in AI, Latino in AI) skupione wokół konkretnych grup mniejszościowych mające przeciwdziałać dyskryminacji. W Polsce wdrażanie zastosowań sztucznej inteligencji w życiu publicznym monitorują fundacje takie jak Panoptykon, Moje Państwo czy Centrum Cyfrowe. W Unii Europejskiej powstaje właśnie nowe prawo: akt o sztucznej inteligencji, który – jak mówi Joanna Mazur – ma zdefiniować przyszłość wielu algorytmicznych rozwiązań na wspólnym obszarze. Według pierwszych propozycji zakazane mają być systemy oceny społecznej, a do kategorii wysokiego ryzyka, objętych specjalnym nadzorem, mają należeć takie obszary jak zatrudnienie, sądownictwo i imigracja.
***
Technologie nie są neutralne, nie są biernymi narzędziami w naszych rękach. Bo nie tyle ich używamy, ile z nimi koegzystujemy. Filozofia technologii uczy nas, że technologie mają swoją intencjonalność, w tym sensie, że aktywnie kształtują relacje ludzi z ich światem. Pióro np. wymaga zupełnie innego stylu pisania niż maszyna do pisania i edytor tekstu. Korzystając z pióra, ludzie mają tendencję do tworzenia dłuższych, starannie sformułowanych zdań, podczas gdy maszyna do pisania czy komputer zachęcają do stylu pisania bardziej przypominającego mowę. Analogicznie używając algorytmów automatyzujących podejmowanie decyzji, zaczynamy inaczej myśleć np. o usługach publicznych, polityce społecznej, a oceny eksperckie przenosimy na systemy obliczeniowe.
Automatyzacja prostych, ale pracochłonnych zadań, takich jak wstępna rekrutacja pracowników na podstawie ich CV, jest pomocna i niejednokrotnie konieczna. Gdyby do redakcji „Znaku” napłynęło kilka tysięcy aplikacji na stanowisko redaktorskie, manualna i pogłębiona ocena ich zawartości zajęłaby rekruterowi kilka tygodni. A osoba na tej pozycji z całą pewnością, jak pokazaliśmy, kierowałaby się często nieuświadomionymi preferencjami lub niechęciami. Mając do dyspozycji coraz bardziej kompleksowe i tańsze rozwiązania algorytmiczne, mamy szansę na wygodniejsze życie, oszczędność czasu, a czasami także na przełomowe odkrycia w dziedzinach takich jak medycyna czy biologia. To, na co zwracają uwagę badaczki i aktywiści z obszaru krytycznego podejścia do AI, to szczególna ostrożność wszędzie tam, gdzie dotyczy ona ważnych społecznie, wrażliwych kwestii odnoszących się do ludzkiego życia i dobrostanu, zwłaszcza zaś do grup tradycyjnie nieuprzywilejowanych. W takich przypadkach wyjątkowa dbałość o jakość używanych danych, przejrzystość i wielokrotna weryfikacja przez różne instytucje publiczne może nas uchronić przed ponurymi wizjami znanymi z dystopijnych fabuł o przyszłości. Pomocna może być też filozofia i jej szczególny dział – etyka. Przejawy dyskryminacji i uprzedzeń wpisane w systemy sztucznej inteligencji unaoczniają, jak potrzebna i ważna jest dziś nowa dziedzina: etyka sztucznej inteligencji.